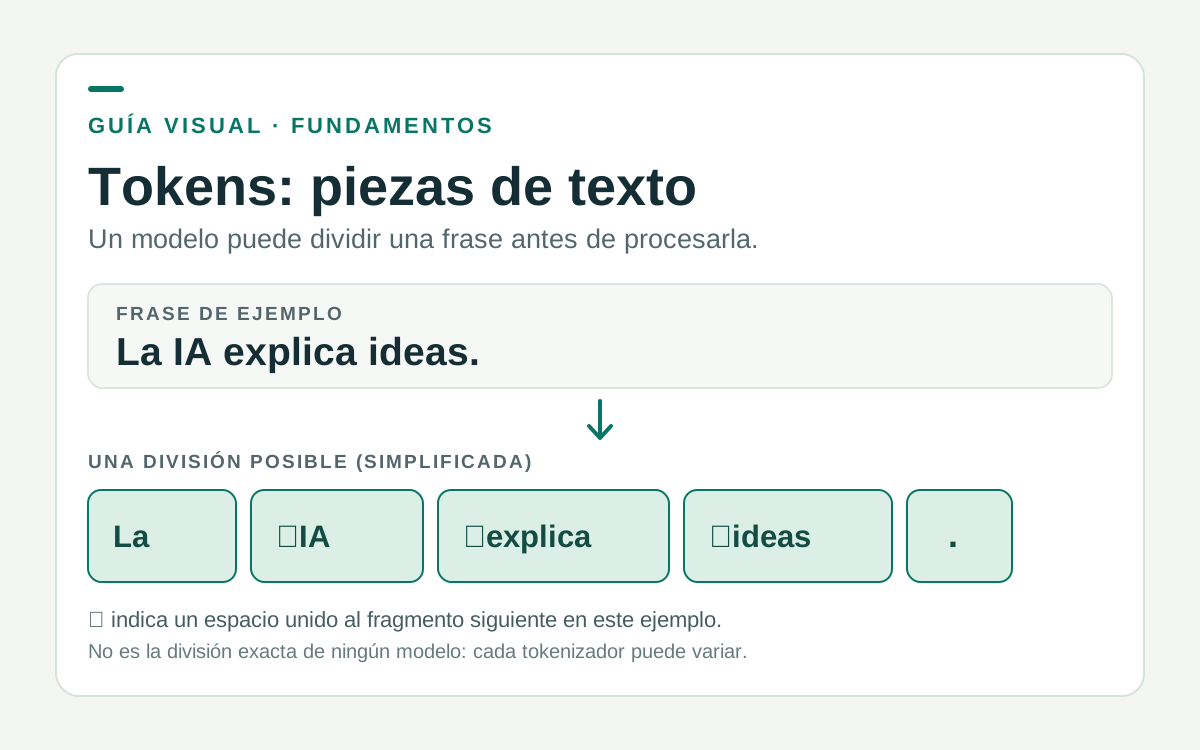
En un modelo de lenguaje, un token es una unidad de texto definida por su tokenizador. Puede representar una palabra, parte de ella o incluso un carácter. El sistema convierte esas unidades en identificadores numéricos para procesarlas; el corte exacto depende del modelo.
Para comprender qué son los tokens en IA, sirve una analogía: son como piezas de construcción de diferentes tamaños. A veces un token coincide con una palabra corta; otras, con un fragmento, un signo de puntuación o una letra.
La unidad básica del lenguaje para las máquinas
El texto que escribimos en una pantalla está lleno de matices, espacios y signos. Antes de que un modelo pueda generar una respuesta o resumir un párrafo, debe aplicar un proceso previo llamado tokenización.
La tokenización consiste en tomar una cadena de caracteres y cortarla en bloques estandarizados según un catálogo predefinido llamado vocabulario. Si el sistema encuentra una palabra común, es probable que la asigne como una unidad completa. Si encuentra una palabra rara, técnica o compuesta, la dividirá en fragmentos más pequeños para poder trabajar con ella sin saturar su lista interna de elementos reconocidos.
Por eso no basta con contar palabras: una misma frase puede requerir más o menos tokens según el tokenizador empleado.
Cómo se divide una frase en la práctica
Observemos cómo se comporta un divisor de texto con ejemplos cotidianos. Tomemos una expresión breve:
- “El gato juega en el jardín.”
Un tokenizador podría conservar algunas palabras completas y separar otras en fragmentos. El punto final puede ser un token independiente o combinarse con otro fragmento. No hay una única división válida para todos los modelos.
Ahora pensemos en una palabra más larga:
- “Desafortunadamente no pudimos contactarlo.”
Un tokenizador puede dividir “Desafortunadamente” en varios fragmentos, pero no podemos afirmar cuáles serán sin consultar el tokenizador concreto. Así puede representar palabras nuevas o poco frecuentes mediante piezas ya disponibles.
Los espacios en blanco, las tildes, los emojis y las mayúsculas también pueden influir en el corte final. Un espacio no siempre se cuenta como token independiente: a veces queda unido al fragmento que viene después.
Por qué los modelos no leen palabras completas
Podría parecer más intuitivo que las máquinas trabajaran directamente con palabras enteras, pero ese enfoque presenta dos grandes inconvenientes prácticos:
- Tamaño inmanejable del vocabulario: Un idioma vivo contiene cientos de miles de palabras, a las que se suman conjugaciones verbales, diminutivos, erratas comunes y tecnicismos. Intentar almacenar cada variante entera exigiría catálogos gigantescos e ineficientes.
- Menor flexibilidad ante lo desconocido: Un catálogo formado solo por palabras completas necesitaría una estrategia adicional para representar erratas o neologismos. Los fragmentos de subpalabras ayudan a procesar términos nuevos con piezas conocidas.
Trabajar a nivel de subpalabras equilibra el tamaño del catálogo con la flexibilidad para procesar múltiples idiomas, código informático y errores comunes de escritura.
La relación entre tokens y límites de procesamiento
Los modelos de lenguaje tienen una capacidad limitada de información que pueden procesar a la vez, denominada habitualmente ventana de contexto. Este límite determina cuánto contenido puede tener en cuenta el modelo al formular una respuesta; no equivale a una memoria permanente.
La ventana de contexto se mide directamente en tokens, no en páginas ni en palabras. Todo cuenta dentro de ese presupuesto:
- La instrucción o pregunta que formula el usuario.
- Los documentos o fragmentos de texto adjuntos.
- El historial previo de la conversación.
- La respuesta que el propio sistema va a generar.
Si una petición supera ese límite, el servicio puede rechazarla, recortarla o resumir parte del historial, según su implementación. Conocer qué son los tokens en IA permite entender por qué una conversación muy larga puede provocar respuestas incompletas o la pérdida de detalles anteriores.