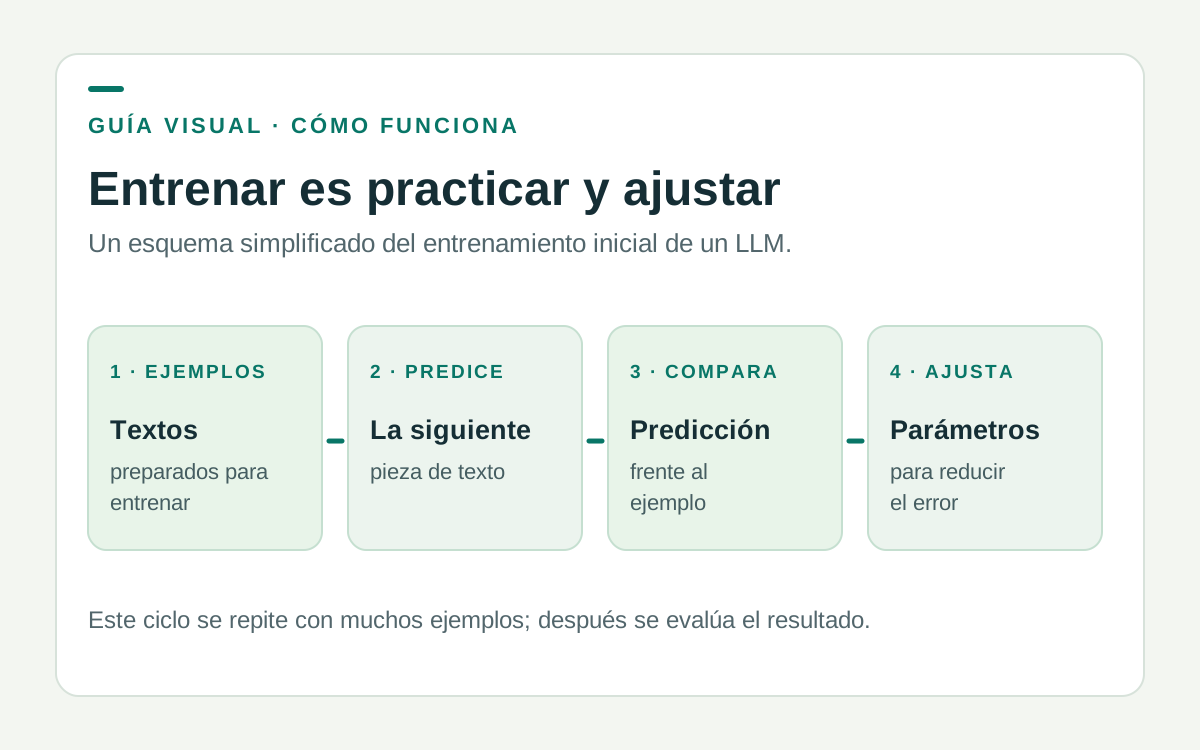
Entrenar un modelo de lenguaje grande —o LLM— es prepararlo para continuar textos y, mediante etapas adicionales, responder a instrucciones. No se le entrega un manual con todas las respuestas. Se le muestran muchos ejemplos y se ajusta su funcionamiento cuando sus predicciones fallan. Esta explicación se queda con la idea básica; los métodos concretos varían entre modelos.
Primero hacen falta ejemplos
La materia prima suele ser texto: libros, páginas, documentos u otros conjuntos preparados para entrenar, según el modelo y las decisiones de quien lo desarrolla. Importa tanto la cantidad como la selección. Si los ejemplos contienen errores, sesgos o información sensible, el resultado puede arrastrar esos problemas. No podemos saber qué documentos concretos usó un modelo comercial salvo en la medida en que su fabricante lo explique.
Para trabajar con ellos, el sistema divide el texto en piezas pequeñas llamadas tokens. Una pieza puede ser una palabra, parte de una palabra o un signo de puntuación. Después convierte esas piezas en números. No hace falta conocer las matemáticas para entender la idea: el ordenador necesita representar el texto en una forma con la que pueda calcular.
Practica completando lo que falta
Piensa en «Está lloviendo; antes de salir cojo el…». Una continuación plausible sería «paraguas». En una fase habitual de entrenamiento, el modelo recibe fragmentos de texto, intenta anticipar la siguiente pieza y compara su predicción con la continuación que había en el ejemplo. A partir de la diferencia, se ajustan ligeramente muchísimos valores internos, llamados parámetros. El proceso se repite una gran cantidad de veces.
De ese modo aprende relaciones entre palabras, expresiones y contextos. «Banco» no apunta siempre a lo mismo: la conversación puede hablar de dinero o de un asiento. El texto que rodea a la palabra ayuda al modelo a elegir una continuación adecuada. Esto explica parte de su fluidez, pero no garantiza que una respuesta sea verdadera.
Después puede aprender a seguir instrucciones
Completar frases no basta para crear un asistente cómodo de usar. Los desarrolladores pueden añadir otras fases de entrenamiento con ejemplos de preguntas y respuestas, preferencias humanas u otras señales. Así orientan el comportamiento hacia tareas como resumir, explicar o seguir una petición. Los métodos concretos varían de un producto a otro; no todos pasan por las mismas etapas.
También es útil separar entrenamiento de uso. Cuando escribes una pregunta en un chat, normalmente estás usando un modelo ya entrenado para generar una respuesta. Tu mensaje no equivale a repetir todo su entrenamiento. Las reglas de conservación o uso posterior de esa conversación dependen del servicio y de su configuración de privacidad.
Lo que el entrenamiento no garantiza
Un LLM puede redactar una explicación convincente y equivocarse en un dato, mezclar fechas o inventar una referencia. Haber visto muchos ejemplos no lo convierte en una enciclopedia infalible ni en un buscador de fuentes por defecto. Para asuntos importantes conviene comprobar la respuesta en documentos fiables y no compartir información sensible sin revisar las condiciones del servicio.
La idea clave de cómo se entrena un LLM es esta: predice, compara, ajusta y repite. Las fases posteriores pueden hacerlo más útil para conversar, pero la verificación de sus respuestas sigue siendo responsabilidad de quien lo usa.